AIクローラー一覧|止めていいもの・止めてはいけないもの【472サイトでAIを名指ししていたのは3件だけ】
公開日: / 更新日: / カテゴリ: AI検索対策 / 執筆: エラバレル
「GPTBotを止めたほうがいいと聞いたけれど、止めるとChatGPTに出なくなるのでは?」「AIクローラーの名前がたくさんあって、どれが何なのか分からない」。AIで調べものをする人が増え、こうした相談が増えています。
先に結論をお伝えします。AIクローラーは、同じ会社のものでも「AIの学習用」「AI検索用」「利用者に頼まれてページを開く用」に分かれていて、止めてもよいのは学習用だけです。検索用を止めると、ChatGPTやPerplexityの回答にあなたのサイトが出なくなります。
選ばれるAI診断が、税理士事務所・整体院・工務店・歯科医院・クリニックの公式サイト472件のrobots.txtを調べたところ、AIのクローラーを名指しで設定していたのはわずか3件でした。一方で、気づかないうちにGoogleも含めて「全部拒否」になっていたサイトが2件ありました。
この記事では、主なAIクローラーを用途別に一覧にし、止めてよいもの・止めてはいけないものの見分け方、robots.txtでの書き分け方(コピペ用)、よくある書き間違い、自分のサイトの確認方法までをまとめて解説します。
この記事でわかること
- AIクローラーとは何か、3つの種類と止めたときの影響
- 主なAIクローラーの名前(User-agent)と用途の一覧
- robots.txtを守るクローラーと、守らない場合があるクローラー
- 472サイトのrobots.txtを調べて分かった実態
- そのまま使えるrobots.txtの設定例(3パターン)と書き間違いの防ぎ方
- 自分のサイトがAIを止めていないかの確認手順
AIクローラーとは? 3つの種類と止めたときの影響
AIクローラー(AIボットとも呼ばれます)は、ホームページを自動で読みに来るプログラムのうち、AIのサービスのために動いているものです。Google検索のために動く「Googlebot」と同じように、ページを1枚ずつ開いて中身を持ち帰ります。
違うのは、持ち帰った中身の使い道です。AIクローラーは、用途によって次の3種類に分かれます。
| 種類 | 何のために読むか | 止めるとどうなるか |
|---|---|---|
| 学習用 | AIの頭脳(言語モデル)を作るための文章集め | 将来のAIの「知識」にあなたのサイトの内容が入りにくくなる。検索の回答への表示には直接は影響しない |
| 検索用 | AI検索で回答の出典として使うために、ページを登録しておく | AI検索の回答や出典リンクに出なくなる |
| 利用者の依頼用 | 利用者が「このページを読んで」と頼んだときに、その場で開く | 頼まれても内容を読めなくなる |
いちばん多い誤解は「GPTBotを止めると、ChatGPTに出なくなる」というものです。ChatGPTの検索に関係するのはOAI-SearchBotで、GPTBotは学習用です。OpenAIは、この2つを別々に設定できると公式に説明しています。
止めてよいのは「学習用」だけ
集客のためにホームページを持っているなら、検索用と利用者の依頼用のクローラーは止めないのが基本です。学習用を止めるかどうかは、会員限定の記事や有料のデータを扱っているかなど、自分の商売に合わせて決めます。
「学習」と「検索」は何が違うのか
学習用のクローラーが集めた文章は、AIのモデルを作るときの材料になります。モデルができあがるまでには時間がかかるので、今日のページの内容がすぐにAIの回答に反映されるわけではありません。
一方、検索用のクローラーは、AIが質問に答えるときに「今のウェブの情報」を参照するために、ページを登録しておく役目です。ChatGPTの検索機能やPerplexityが回答の下に出典のリンクを並べるのは、この仕組みによるものです。小さな会社や店にとって集客に直結するのは、こちらの検索用です。
主なAIクローラーの一覧
robots.txtで指定するときの名前(User-agent)と用途です。2026年9月時点で、各社が公開している情報をもとにまとめました。User-agentとは、クローラーがアクセスするときに名乗る名前のことで、robots.txtではこの名前ごとに許可・拒否を書き分けます。
検索用・利用者の依頼用(集客したいなら止めない)
| User-agent | 会社 | 用途 |
|---|---|---|
| OAI-SearchBot | OpenAI | ChatGPTの検索機能で、サイトを回答や出典に出すため |
| ChatGPT-User | OpenAI | 利用者の依頼でChatGPTがページを開くとき |
| Claude-SearchBot | Anthropic | Claudeの検索結果の質を上げるための登録 |
| Claude-User | Anthropic | 利用者の質問に答えるため、Claudeがページを開くとき |
| PerplexityBot | Perplexity | Perplexityの検索結果に表示・リンクするため(学習には使わないと明記) |
| Perplexity-User | Perplexity | 利用者の質問に答えるため、その場でページを開くとき |
| Googlebot | Google検索と「AIによる概要」「AIモード」 | |
| bingbot | Microsoft | Bing検索とCopilot。ChatGPTの検索もBingの結果を使っている |
この表の中で特に大事なのは、Googlebotとbingbotです。GoogleのAIによる概要やAIモードは、ふつうのGoogle検索と同じGooglebotが読んだ情報をもとにしています。また、ChatGPTの検索はBingの検索結果も使っているため、bingbotを止めるとChatGPTにも影響が出ることがあります。Bingへの登録についてはBing Webmaster Toolsの記事で説明しています。
学習用(止めても検索への表示には直接影響しない)
| User-agent | 会社 | 用途 |
|---|---|---|
| GPTBot | OpenAI | ChatGPTなどのAIモデルの学習 |
| ClaudeBot | Anthropic | ClaudeなどのAIモデルの学習 |
| Google-Extended | Geminiの学習など。Googleは「Google検索への登録や順位には影響しない」と明記 | |
| Applebot-Extended | Apple | AppleのAIモデルの学習 |
| CCBot | Common Crawl | 公開データの収集。多くのAIの学習に使われている |
| meta-externalagent | Meta | MetaのAIの学習など |
| Bytespider | ByteDance | TikTokの運営会社のクローラー |
| anthropic-ai | Anthropic | 古い名前。今はClaudeBotなどに分かれているが、念のため書く人が多い |
Google-Extendedは実際に読みに来るクローラーの名前ではなく、「Googleの学習に使ってよいか」を伝えるための目印です。読みに来るのはふつうのGooglebotです。そのため、Google-Extendedを拒否しても、Google検索やAIによる概要への表示には影響しないとGoogleは説明しています。
「Googlebotを止めればGoogleのAIに使われない」は間違い
GoogleのAIによる概要に使われたくないからといってGooglebotを止めると、ふつうのGoogle検索にも出なくなります。Googleの検索結果から消えるのは、小さな会社にとって大きな損失です。Googleの学習だけを止めたいなら、Googlebotではなく Google-Extended を指定してください。
名前は変わることがある
AIクローラーの名前は、各社がサービスを整理するたびに増えたり、分かれたりしています。たとえばAnthropicは、以前は「anthropic-ai」「Claude-Web」という名前を使っていましたが、今は学習用・検索用・利用者の依頼用で名前を分けています。
robots.txtに書く名前は、年に一度くらいは各社の公式ページ(この記事の最後の「参考にした資料」)で確かめると安心です。ただし、集客したいサイトが「すべて許可」にしているなら、名前が変わっても困ることはありません。
robots.txtを守るクローラー・守らないクローラー
robots.txtは「ここは読まないでください」というお願いのファイルで、強制力はありません。ただ、主な会社は守ると公表しています。
- OpenAI(OAI-SearchBot・GPTBot)、Anthropic(ClaudeBot など)、PerplexityBot、Googlebot、bingbot は、robots.txtに従うと公表しています
- ChatGPT-User と Perplexity-User は、robots.txtが当てはまらない場合があると、それぞれの会社が説明しています。利用者自身が「このページを読んで」と頼んだ操作だからです
- 名前を名乗らずに読みに来るプログラムは、robots.txtでは止められません。本当に読ませたくない情報は、ログインが必要な場所に置くしかありません
OpenAIは、OAI-SearchBotの設定を変えると、反映まで約24時間かかると説明しています。
robots.txt と noindex の違い
robots.txtは「読みに来ないで」というお願いで、noindex は「読んでもいいけれど検索結果には載せないで」という指定です。robots.txtで拒否したページは中身を読まれないため、ページに書いた noindex にも気づいてもらえません。検索結果から確実に外したいページは、robots.txtで止めずに noindex を使うのが基本です。詳しくはnoindexの確認方法の記事で説明しています。
472サイトのrobots.txtを調べた結果
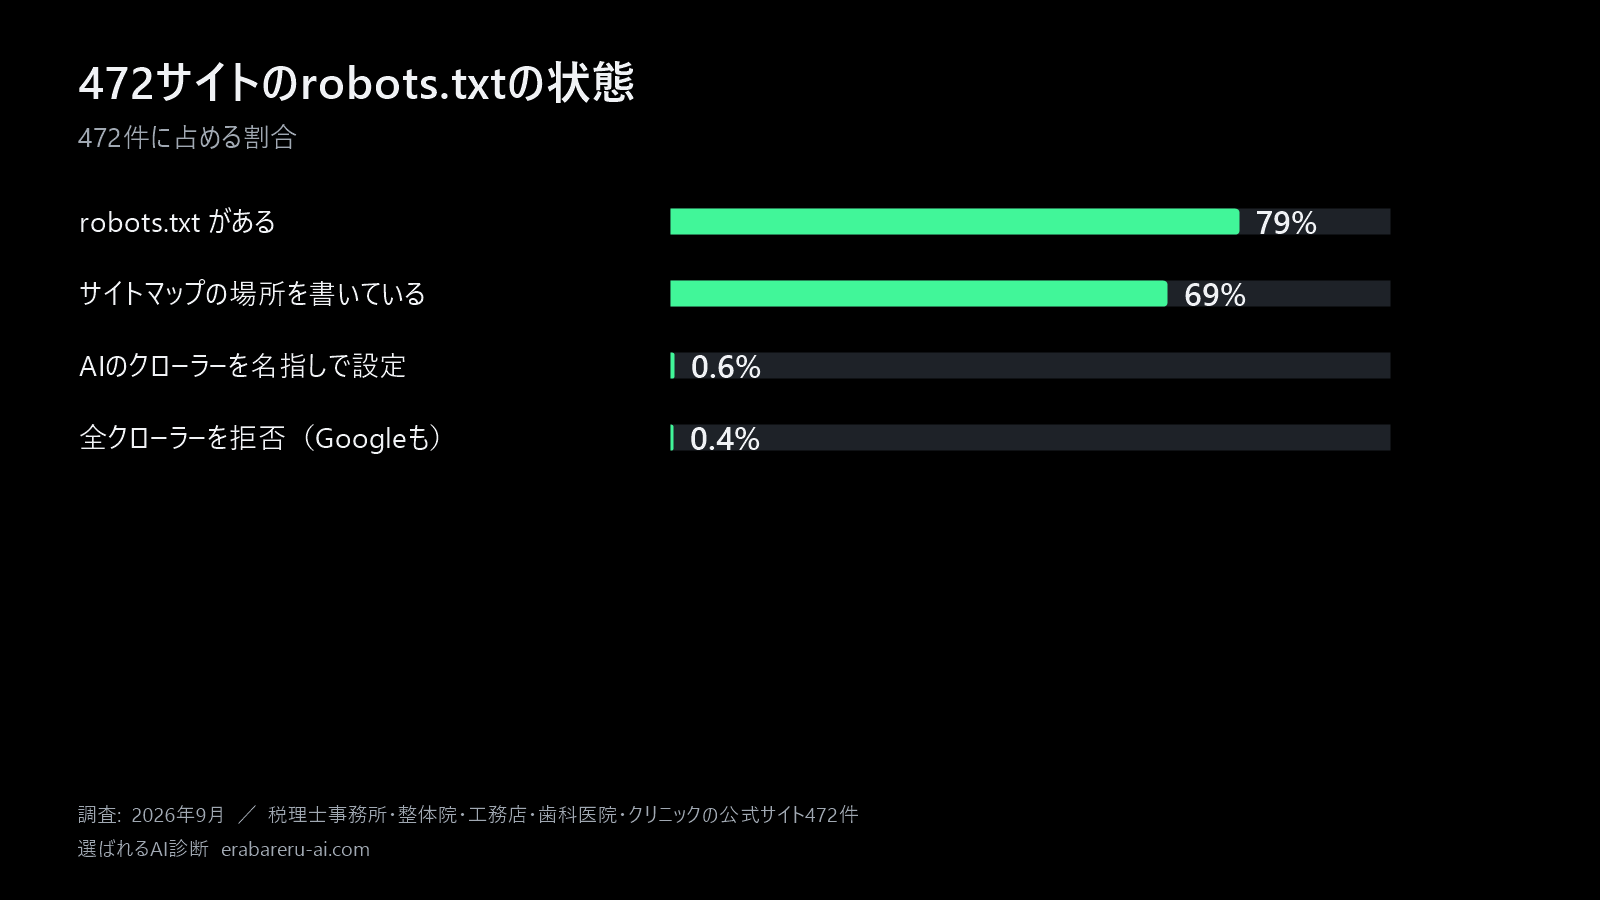
ここからは、選ばれるAI診断の独自調査です。2026年9月に、税理士事務所・整体院・工務店・歯科医院・クリニックの公式サイト472件の /robots.txt を取得しました。
| 状態 | 件数 |
|---|---|
| robots.txtがある | 372件(79%) |
| robots.txtがない(すべてのクローラーを受け入れる状態) | 100件(21%) |
| AIのクローラーを名指しで設定している | 3件(0.6%) |
| すべてのクローラーを拒否している(Googleも含む) | 2件 |
| サイトマップの場所を書いている | 325件 |
調査の結果
- 472件のうち、robots.txtがあったのは372件(79%)、なかったのは100件(21%)
- GPTBotやClaudeBotなど、AIのクローラーを名指しで設定していたのは3件(0.6%)だけ
- Googleも含めて、すべてのクローラーを拒否していたサイトが2件
- robots.txtにサイトマップの場所を書いていたのは325件
- 2026年10月2日に見直した採点基準で22業種2,296件を再診断した結果でも、「AI検索のクローラーを塞いでいないか」で不足となったのは約1%
AIを名指ししていたのは、たった3件
472件のうち、GPTBotやClaudeBotなどAIのクローラーを名前で書いていたのは3件だけでした。
- 2件は「AIのクローラーを許可する」設定でした(AIに引用されたいという意図の設定)
- 1件は、ホームページ作成サービス(Squarespace)の、AIのクローラーをまとめて止める設定が入っていました
残りの469件は、AIについて何も書いていません。robots.txtに書いていなければ、AIのクローラーは「許可」の扱いになります。つまり、小さな会社のホームページのほとんどは、AIに読まれる状態になっています。わざわざ許可の設定を書き足す必要はありません。
ホームページ作成サービスを使っている場合は、サービス側の設定でAIのクローラーを止める項目があることがあります。自分では書いた覚えがなくても、robots.txtに見慣れない名前が並んでいたら、サービスの管理画面を確認してください。
気づかずに「全部拒否」になっていたサイトが2件
一方で、Googleも含めたすべてのクローラーを拒否していたサイトが2件ありました。
- 1件はWordPressのサイトで、
User-agent: *の下にDisallow: /と書かれていました。制作中に検索よけのためにrobots.txtを書き換え、公開後に戻し忘れたものと考えられます。制作中の「検索よけ」を公開後に外し忘れるのは、よくある事故です - もう1件は、AIを止める設定の書き方の影響で、
User-agent: *(すべてのクローラー)も同じグループに入り、全体が拒否になっていました
どちらも、Google検索にも、AI検索にも出にくい状態です。AIを止めるつもりで、検索まで止めてしまう事故は、書き方ひとつで起きます。WordPressの「検索エンジンでの表示」の設定については、WordPressの「検索エンジンがインデックスしないようにする」の記事で詳しく説明しています。
robots.txtに書いていなくても止まっている場合がある
robots.txtの外で止まっているケースもあります。レンタルサーバーによっては、管理画面に「AIクローラーを遮断する」設定があり、オンにするとサーバーの段階でAIのクローラーを弾きます。この場合、robots.txtを見ても何も書かれていないのに、AIは読めません。
その後の調査で、809の公式サイトにAIのクローラーの名前で接続したところ、学習用のGPTBotは20%のサイトでサーバーの段階で拒否されていました(検索用はほとんど止まっていませんでした)。詳しくはCloudflareやレンタルサーバーでのAIの遮断の記事で紹介しています。サーバー会社やCloudflareの管理画面も確認してください。
robots.txtの書き方(コピペ用)
robots.txtは、サイトのいちばん上の階層(https://example.com/robots.txt)に置くテキストファイルです。「User-agent:(どのクローラーに)」と「Disallow:(どこを読まないでほしいか)」を組み合わせて書きます。
| 書き方 | 意味 |
|---|---|
User-agent: * | すべてのクローラー |
User-agent: GPTBot | GPTBotだけ |
Disallow: / | サイト全体を読まないで |
Disallow:(空欄) | どこを読んでもよい |
Disallow: /admin/ | /admin/ から始まる場所だけ読まないで |
Sitemap: https://…/sitemap.xml | サイトマップの場所を伝える |
パターン1:すべて許可する(小さな会社におすすめ)
集客したいサイトは、これで十分です。robots.txtがない状態と同じ意味です。
User-agent: *
Disallow:

Sitemap: https://example.com/sitemap.xmlサイトマップの行は必須ではありませんが、書いておくとクローラーがページの一覧を見つけやすくなります。WordPressのサイトマップの場所はWordPressのサイトマップの記事で確認できます。
パターン2:学習用だけ止めて、検索用は許可する
「AIの学習に自分の文章を使われたくない。でも、AI検索には出たい」という場合です。
User-agent: GPTBot
Disallow: /

User-agent: ClaudeBot
Disallow: /

User-agent: Google-Extended
Disallow: /

User-agent: Applebot-Extended
Disallow: /

User-agent: CCBot
Disallow: /

User-agent: *
Disallow:

Sitemap: https://example.com/sitemap.xml
それぞれのまとまりの間に、必ず空行を1行入れてください。OAI-SearchBot・Claude-SearchBot・PerplexityBotは書いていないので、最後の User-agent: * の「すべて許可」が当てはまります。
パターン3:AIをすべて止める(検索にも出なくなる)
有料の会員向けの記事や、独自のデータベースを売っているサイトなど、AIに読まれると商売が成り立たない場合だけです。AI検索の回答には出なくなります。
User-agent: GPTBot
Disallow: /

User-agent: OAI-SearchBot
Disallow: /

User-agent: ClaudeBot
Disallow: /

User-agent: Claude-SearchBot
Disallow: /

User-agent: PerplexityBot
Disallow: /

User-agent: Google-Extended
Disallow: /

User-agent: *
Disallow:
この設定でも、Googlebotは止めていないため、Google検索とAIによる概要には引き続き出ます。
業種ごとの選び方の例
〇〇整体院(集客が目的のホームページ):パターン1。何も書かないか「すべて許可」で十分です。
〇〇税理士事務所(ブログで税の解説を書いている):基本はパターン1。解説記事をAIの学習に使われたくない場合はパターン2にして、検索用は許可します。
〇〇学習塾(会員だけが見られる教材ページがある):教材ページはログインが必要な場所に置き、公開ページはパターン1にします。robots.txtだけで教材を守ろうとしないのがポイントです。
書くときの注意
- **
User-agent: *の行を、AIの名前と同じまとまりに入れない。** 空行をはさまずに並べると、同じ設定が全部に当てはまります。上の調査で「全部拒否」になっていた原因のひとつです - **名前を指定したまとまりは、
*の設定を引き継がない。** たとえば*にDisallow: /admin/と書いていても、User-agent: GPTBotのまとまりには、もう一度書く必要があります - **
Disallow: /は「サイト全体を拒否」、Disallow:(何も書かない)は「全部許可」。** 1文字の違いで正反対になります - 大文字・小文字、つづりを正確に。 間違った名前は無視されます
選ぶだけでrobots.txtを作れるツールも用意しています。書き間違いが心配な方は、robots.txt作成ツールをお使いください。
自分のサイトが止めていないか確認する方法
設定を変えていないつもりでも、制作会社やサービスの設定で止まっていることがあります。次の順番で確認してください。
- ブラウザで
https://自分のドメイン/robots.txtを開く Disallow: /という行がないか探す。あれば、その上のUser-agent:に何が書いてあるかを見るUser-agent: *の下にDisallow: /があれば、Googleも含めて全部拒否になっている- WordPressなら、管理画面の「設定 → 表示設定」で「検索エンジンがサイトをインデックスしないようにする」のチェックが外れているか確認する(今のWordPressでは、このチェックはrobots.txtではなく、ページに noindex のタグを入れる形で検索を止めます)
- レンタルサーバーの管理画面に、AIクローラーの遮断設定がないか確認する
AIクローラーの確認チェックリスト
- robots.txtに
User-agent: *とDisallow: /の組み合わせがない - OAI-SearchBot・Claude-SearchBot・PerplexityBotを拒否していない
- Googlebot・bingbotを拒否していない
- AIの名前と
User-agent: *の間に空行が入っている - レンタルサーバーやCloudflareで、AIクローラーの遮断をオンにしていない
- WordPressの「検索エンジンがサイトをインデックスしないようにする」にチェックが入っていない
robots.txtの読み方をもっと詳しく知りたい方は、robots.txtの確認方法の記事もあわせてご覧ください。
選ばれるAI診断では、ChatGPT・Perplexity・Claude・Google・Bingの検索用クローラーが止められていないか、学習用クローラーをどうしているかを、URLを入れるだけで確認できます。
自分のサイトを、無料で診断するGPTBotやClaudeBot(学習用)は止めるべき?
集客したい個人事業主や小さな会社なら、止めなくてよいというのが多くの専門家の見方です。
- 学習用を止めても、AI検索への表示は直接は変わらない。ただ、将来のAIが「知識として」あなたの店や事務所を知っている可能性は下がる
- AIに名前を覚えてもらうことは、広告費のかからない宣伝でもある
- 一方で、会員限定の記事や、有料で売っているデータ・文章があるなら、学習用は止める理由がある
迷ったら「検索用は必ず許可、学習用は自分の商売次第」と覚えておけば間違いありません。
| 状況 | おすすめの設定 |
|---|---|
| 店や事務所の集客が目的 | すべて許可(パターン1) |
| 独自の解説記事が多く、学習には使われたくない | 学習用だけ止める(パターン2) |
| 会員限定・有料の文章やデータを売っている | 該当ページはログインの中へ。必要ならパターン3 |
| 何を選べばよいか分からない | すべて許可(パターン1) |
「なんとなく不安だから止める」は、集客の機会を減らすだけになりがちです。止める前に、守りたいものが何なのかを書き出してみてください。
AIクローラーを許可したあとにやること
AIクローラーに読まれる状態になっていても、それだけでAIの回答に選ばれるわけではありません。読まれたあとに「この店(事務所)は信頼できる情報源だ」と判断してもらうための土台が必要です。
選ばれるAI診断が2026年10月2日に見直した採点基準で、22業種2,296件の公式サイトを再診断したところ、クローラーを塞いでいるサイトは約1%しかありませんでした。一方で、次の項目はほとんどのサイトで不足していました。
| 不足していた項目 | サイトの割合 |
|---|---|
| 運営者の情報が構造化データに十分入っていない | 97% |
| 質問に答える形の見出しが少ない | 91% |
| ページの内容を構造化データで伝えていない | 91% |
| 見出しの直後に短い答えがない | 83% |
つまり、多くの小さな会社にとっての課題は「AIに読まれないこと」ではなく、読まれたあとに、何の会社で、何に答えているページなのかが伝わらないことです。構造化データ(ページの内容をAIや検索エンジンに伝えるための決まった書き方)は、入力欄を埋めるだけでコードを作れるツールもあります。
構造化データ作成ツールを使う(無料)AIごとの対策は、Perplexityに引用されるための記事やGeminiに紹介されるための記事でも紹介しています。
よくある質問
robots.txtがないと、AIに読まれないのですか?
いいえ。robots.txtがなければ、すべてのクローラーを受け入れる扱いになります。今回の調査でも472件中100件にはrobots.txtがありませんでしたが、それでAIに読まれないということはありません。
GPTBotを止めると、ChatGPTに表示されなくなりますか?
直接は影響しません。ChatGPTの検索機能で使われるのはOAI-SearchBotで、GPTBotはAIモデルの学習用です。OpenAIは、この2つを別々に設定できると説明しています。ChatGPTに出たいなら、OAI-SearchBotを止めないことが大事です。
llms.txtに書けば、AIのクローラーを止められますか?
止められません。llms.txtはAIへの「案内板」で、アクセスを制御する仕組みではありません。止めたいならrobots.txtで設定します。llms.txtについてはllms.txtは必要かの記事で詳しく説明しています。
設定を変えたら、すぐに反映されますか?
クローラーがrobots.txtを読み直すまで時間がかかります。OpenAIはOAI-SearchBotについて約24時間と説明しています。ほかも数日かかることがあります。
Google-Extendedを拒否すると、Google検索の順位が下がりますか?
下がりません。Googleは、Google-ExtendedはGoogle検索への登録や順位には影響しないと説明しています。Google-Extendedは、Geminiの学習などに使ってよいかを伝える目印です。
Instagramやホットペッパーの自分の店のページも、AIに読まれていますか?
それぞれのサービスのrobots.txtで決まるため、店側では変えられません。自分で設定を決められるのは、自分のホームページだけです。
まとめ
AIクローラーの種類と、小さな会社がとるべき設定をまとめます。
この記事のまとめ
- AIクローラーは「学習用」「検索用」「利用者の依頼用」の3種類。止めてよいのは学習用だけ
- GPTBotを止めてもChatGPTの検索には出る。検索に関係するのはOAI-SearchBot。Googleの学習だけ止めたいならGoogle-Extendedを指定する
- 472の公式サイトのうち、AIを名指しで設定していたのは3件。ほとんどのサイトは何も書いておらず、AIに読まれる状態
- 一方で、Googleも含めて全部拒否になっていたサイトが2件あった。WordPressの設定の外し忘れや、書き方の間違いが原因
- 集客したいなら「すべて許可」で十分。学習だけ止めたいなら、検索用を止めないように書き分ける
- クローラーを許可したあとは、運営者の情報や質問に答える見出しなど、読まれたあとの土台を整える
まずは、自分のサイトがAIのクローラーを止めていないか、ほかに足りないところがないかを確かめてください。選ばれるAI診断なら、URLを入れるだけで、22項目の判定と理由を無料で確認できます。
自分のサイトを、無料で診断する参考にした資料
- Overview of OpenAI Crawlers(OpenAI)
- Does Anthropic crawl data from the web, and how can site owners block the crawler?(Anthropic)
- Perplexity Crawlers(Perplexity)
- Google の一般的なクローラー(Google 検索セントラル)
調査の方法:2026年9月、選ばれるAI診断で診断した税理士事務所・整体院・工務店・歯科医院・クリニックの公式サイト472件(重複を除く)の /robots.txt を取得し、User-agentごとの許可・拒否を集計しました。あわせて、2026年10月2日に見直した採点基準で再診断した22業種2,296件の結果から、主な項目の不足の割合を示しています。個別のサイト名は公開していません。